「做题记录」串串选做
stripe_python
·
2026-03-30 19:54:52
·
算法·理论
KMP
问题 1 定义前缀函数 \pi[i] 为前缀 S[:i] 最长 border。求出 \pi[1] \sim \pi[n] 。
连边 i \to \pi[i] 形成 fail 树。fail 树刻画了所有 border 形成的树形结构。
扫描 i = 1\to n ,在 fail 树上暴力挂叶子。直接跳右根链,判定当前字符能否接在某个 border 后面。复杂度均摊线性。
:::::info[代码]
for (int i = 2, j = 0; i <= n; i++) {
    while (j && s[i] != s[j+1]) j = pi[j];
    if (s[i] == s[j+1]) j++;
    pi[i] = j;
}
:::::
问题 2 给定字符串 S ,构造 DFA,接受且仅接受以 S 为后缀的串。
取最长匹配长度 i 为状态,转移函数
\delta(i,c)= \left\{\begin{matrix}
i+1 & i<n\land S[i+1]=c\\
0 & i=0 \land S[1] \ne c \\
\delta(\pi(i),c) & \text{otherwise.}
\end{matrix}
\right.
接受状态为 n 。节点数 O(n) ,转移数 O(n |\Sigma|) ,称作 KMP 自动机。
问题 3 给定文本串 T 和模式串 S ,求 S 在 T 中所有出现位置。
对 S 建立 KMP 自动机,输入 T 逐位转移,走到 |S| 则匹配成功,退回 \pi[n] 继续找。
实际上可以避免显式建自动机做到 O(n) 。
问题 4 (P5829)给定字符串 S ,进行 q 次询问,给定 x,y ,求 S[:x] 和 S[:y] 的最长公共 border。
所有 border 形成树形结构。建 fail 树 i \to \pi[i] ,所求转化为 x,y 的 LCA。
ACAM
问题 1 给定字符串 S_1 \sim S_n ,构造 DFA,接受且仅接受以某个 S_i 为后缀的串。
对 S_1 \sim S_n 建出 Trie,将 KMP 自动机上树。
定义节点 fail 指针为,当前串的最长真后缀,并且这个后缀对应 Trie 上某个点。转移函数
\delta(i,c)= \left\{\begin{matrix}
v & v=\text{son}(u,c) \text{ exists.}\\
\delta(\text{fail}(u),c) & \text{otherwise.}
\end{matrix}\right.
特别地,根节点失配的转移边是自环。
构造 ACAM 可以在 Trie 上 BFS。对队首节点 u 枚举转移边 c :
若 \delta(u,c) 存在,令 \text{fail}(\delta(u,c)) \gets \delta(\text{fail}(u),c) 。
若 \delta(u,c) 不存在,令 \delta(u,c) \gets \delta(\text{fail}(u),c) 。
注
取 Trie 中所有模式串结尾的节点集合 E ,接受状态为 \{u \mid \exists k \ge 0, \text{fail}^k(u) \in E\} 。
节点数 O(L) ,转移数 O(L |\Sigma|) ,称作 AC 自动机 / ACAM。
:::::info[代码]
struct ACAM {
    struct node {
        int to[26], fail;
    } T[N];
    int tot = 0;
    void insert(const string& s, int id) {
        int u = 0;
        for (char c : s) {
            int& v = T[u].to[c-'a'];
            if (!v) v = ++tot;
            u = v;
        }
    }
    void build() {
        queue<int> Q;
        for (int c = 0; c < 26; c++)
            if (T[0].to[c]) Q.emplace(T[0].to[c]);
        while (!Q.empty()) {
            int u = Q.front(); Q.pop();
            for (int c = 0; c < 26; c++) {
                int& v = T[u].to[c];
                int x = T[T[u].fail].to[c];
                if (!v) {v = x; continue;}
                T[v].fail = x, Q.emplace(v);
            }
        }
    }
} AC;
:::::
问题 2 (P3808)给定模式串 S_1 \sim S_n 和文本串 T ,求在 T 中出现的文本串数目。
对 S_1 \sim S_n 构造 ACAM,输入 T 逐位转移。考察每个走到的节点 u ,向上跳 fail 链找 E 中节点,计入 \text{cnt} 的贡献并标记去重。
跳 fail 链的过程中,遇到被标记点就终止循环,复杂度可以均摊到 O(L) 。
问题 3 (P5357)给定模式串 S_1 \sim S_n 和文本串 T ,对每个 i 求出 S_i 在 T 中出现次数。
对 S_1 \sim S_n 构造 ACAM,输入 T 逐位转移。考察每个走到的节点 u ,向上跳 fail 链令 \text{ans}_i \gets \text{ans}_i+1 。复杂度 O(L^2) 。
连边 u \to \text{fail}(u) 形成 fail 树。转移 T 只求出每个点被经过的次数,最后再对 fail 树做前缀和即可优化到 O(L) 。代码。
Manacher
问题 给定字符串 S ,对每个 i 求出最长回文半径 d_i 。
顺序扫描 i =1\to n ,维护 [l,r] 为覆盖当前 i 的最长回文区间。根据回文串对称性分讨:
若 l+r-i 对应回文串被 [l,r] 包含,直接查表。
若 l+r-i 对应回文串超出 [l,r] ,向外暴力扩展。
求出 i 后对应更新 [l,r] 。复杂度均摊线性。
:::::info[代码]
for (int i = 1, l = 1, r = 0; i <= n; i++) {
    int k = i > r ? 1 : min(d1[l+r-i], r-i+1);
    while (1 <= i-k && i+k <= n && s[i-k] == s[i+k]) k++;
    d1[i] = k--;
    if (i+k > r) l = i-k, r = i+k;
}
for (int i = 2, l = 1, r = 0; i <= n; i++) {
    int k = i > r ? 0 : min(d2[l+r-i+1], r-i+1);
    while (1 <= i-k-1 && i+k <= n && s[i-k-1] == s[i+k]) k++;
    d2[i] = k--;
    if (i+k > r) l = i-k-1, r = i+k;
}
:::::
上面的代码只能求奇回文串。偶回文串可以单独讨论,也可以将原串变为
{\tt{!\#}}S_1 {\tt{\#}} S_2 {\tt{\#}} \cdots S_n {\tt{\#}} {\tt{?}}
后转化为奇回文情形。
定理 本质不同回文子串至多 n 个。
更强的结论是,每加入一个 i ,本质不同回文子串数至多 +1 ,且必然对应最长的那个子串。
Z 函数 / exKMP
问题 给定字符串 S ,对每个 i 求出 z[i]=\text{lcp}(S,S[i:n]) 。
二分哈希或者 SA 容易做到 1log。
称 [i,i+z[i]-1] 为匹配段。顺序扫描 i=1\to n ,维护最右匹配段 [l,r] 。
若 i>r ,向后暴力扩展。
若 i \le r ,根据 LCP 对称性,考察 z[i-l+1] 再暴力扩展。
复杂度均摊线性。
:::::info[代码]
void exkmp() {
    z[1] = n;
    for (int i = 2, l = 1, r = 1; i <= n; i++) {
        z[i] = i > r ? 0 : min(z[i-l+1], r-i+1);
        while (i+z[i] <= n && s[z[i]+1] == s[z[i]+i]) z[i]++;
        if (i+z[i]-1 > r) l = i, r = i+z[i]-1;
    }
}
:::::
后缀数组
对于字符串 S ,定义 \text{sa}[i] 为将 S 排序后第 i 小后缀的标号,\text{rk}[i] 为标号为 i 的后缀排序。根据定义,\text{sa} 和 \text{rk} 互为逆排列。
记 \text{lcp}(i,j) 为 S[i:n] 和 S[j:n] 的 LCP 长度,设 \text{ht}[i]=\text{lcp}(\text{sa}[i-1],\text{sa}[i]) 。
- 我们常常会对 $\text{ht}$ 建小根笛卡尔树。这个结构的本质是后缀树。
本质不同子串数 \dbinom{n}{2}-\sum\limits_{i=2}^n \text{ht}[i] 。
:::::success[哈希]
初始化 \text{sa} 为单位排列,对其进行排序。每轮 cmp 只要比较两个后缀的字典序,二分哈希求 LCP 长后比较下一位即可。
复杂度为 O(n \log^2 n) 。建议使用倍增求 LCP 配合 std::stable_sort。
:::::
:::::success[倍增]{open}
考虑在第 k 轮排序中只比较 S[i:i+2^k-1] 的字典序。
在第 k+1 轮中,我们需要对 (S[i:i+2^k-1], S[i+2^k:i+2^{k+1}-1]) 的二元组排序。这两个东西在上一轮都排好了,所以可以直接 std::sort。复杂度 O(n \log^2 n) 。
由于值域是 O(n) 的,可以用计数排序来优化。对于双关键字排序,还要采用基数排序的思想,先对第二关键字排序,再对第一关键字排序。复杂度 O(n \log n) 。
常数优化:第二关键字排序可以直接模拟;限制值域。
:::::
:::::info[代码]
struct suffix_array {
    int sa[2 * N], rk[2 * N], ht[N], rk0[N], cnt[N], id[N];
    void init(const char* s, int n, int m = 130) {
        for (int i = 1; i <= n; i++) cnt[rk[i] = s[i]]++;
        for (int i = 1; i <= m; i++) cnt[i] += cnt[i-1];
        for (int i = n; i >= 1; i--) sa[cnt[rk[i]]--] = i;
        for (int k = 1, p = 0; p < n; k <<= 1, m = p) {
            int cur = 0;
            for (int i = n-k+1; i <= n; i++) id[++cur] = i;
            for (int i = 1; i <= n; i++) if (sa[i] > k) id[++cur] = sa[i]-k;
            fill(cnt + 1, cnt + m + 1, 0);
            for (int i = 1; i <= n; i++) cnt[rk[id[i]]]++;
            for (int i = 1; i <= m; i++) cnt[i] += cnt[i-1];
            for (int i = n; i >= 1; i--) sa[cnt[rk[id[i]]]--] = id[i];
            p = 0, copy(rk + 1, rk + n + 1, rk0 + 1);
            auto equ = [&](int x, int y) -> bool {
                return rk0[x] == rk0[y] && rk0[x + k] == rk0[y + k];
            };
            for (int i = 1; i <= n; i++) rk[sa[i]] = equ(sa[i - 1], sa[i]) ? p : ++p;
        }
        for (int i = 1, j = 0; i <= n; i++) {
            if (rk[i] == 0) continue;
            for (j ? j-- : 0; s[i+j] == s[sa[rk[i]-1] + j]; ) j++;
            ht[rk[i]] = j;
        }
    }
} SA;
:::::
border 理论
定理 1 周期与 border 对偶 p \in \text{per}(S)\iff n-p \in \text{bd}(S) 。
定理 2 弱周期引理,WPL 若 p, q \in \text{per}(S) 且 p+q \le n ,则 \gcd(p,q) \in \text{per}(S) 。
:::::success[证明]
不妨设 p>q ,下证 p-q 是 S 的周期。
即证 \forall 0 \le i <|S|-p-q,S[i]=S[i+p-q] 。
当 i \ge q 时:
由 q 是周期,S[i]=S[i-q] 。
由 p 是周期,S[i-q]=S[i-q+p] 。
得 S[i]=S[i+p-q] 。
当 i<q 时:
由 |S| \ge p+q 且 i<q ,i+p <p+q \le |S| 。
由 p 是周期,S[i]=S[i+p] 。
由 q 是周期,S[i]=S[i+p-q] 。
下证 \gcd(p,q) 是 S 的周期。
因为 p-q 是 S 的周期,可以不断重复如下过程直到 p=q :
令 p \gets p-q 。
若 p<q ,则交换 p,q ,否则不操作。
上述过程所得的 p,q 均为 S 的周期。
当 p=q 时,由 GCD 的辗转相减法得,最终的数一定为 \gcd(p,q) 。
定理 3 Fine-Wilf 定理,PL 若 p, q \in \text{per}(S) 且 p+q-\gcd(p,q) \le n ,则 \gcd(p,q) \in \text{per}(S) 。
定理 4 对任意 x ,\text{bd}(S) \cap (x,2x] 构成等差数列。
定理 5 \text{bd}(S) 升序排序后,可以划分为 O(\log n) 段等差数列。
定理 6 A^{\infty}<B^{\infty} \iff AB<BA 。
:::::success[证明]
设 \operatorname{LCP}(A^{\infty},B^{\infty})=k 。根据定义,其满足以下两个性质:
不妨设 A^{\infty}<B^{\infty} ,必然有 A^{\infty}[k] < B^{\infty}[k] 。
下证 k<|A|+|B| 。
假设 k \ge |A|+|B| ,此时 A^{\infty} 和 B^{\infty} 的前 |A|+|B| 个字符必定相同,取出这 |A|+|B| 个字符记为字符串 C 。
因为 C 是 A^{\infty} 的前缀,所以 C 具有周期 |A| ,同理其具有周期 |B| 。
而 |C| = |A|+|B| ,根据引理 1 得 x=\gcd(|A|,|B|) 必然是 |C| 的周期。
这说明 A,B 都是由长为 x 的子串组成,即 \exists D, A=D^u, B=D^v ,其中 u,v \in \mathbb{N}^+ 且 |D|=x 。
此时 AB=D^x D^y=D^{x+y} ,BA=D^y D^x=D^{y+x} ,得 AB=BA ,与假定矛盾。
下证 AB 的前 k+1 个字符与 A^{\infty} 相同。
即 \forall 0 \le i \le k, (AB)[i]=A^{\infty}[i] 。
当 i < |A| 时,(AB)[i]=A[i] 且 A^{\infty}[i]=A[i] ,显然相等。
当 |A| \le i \le k 时:
此时 (AB)[i]=B\left[i-|A|\right]=B^{\infty} \left[i-|A|\right] 。
因为 i \le k ,所以 i-|A|<k 。根据性质 1,B^{\infty}[i-|A|]=A^{\infty} [i-|A|] 。
传递得 (AB)[i]=B^{\infty} \left[i-|A|\right]=A^{\infty} [i-|A|]=A^{\infty}[i] 。
同理可得 BA 的前 k+1 个字符与 B^{\infty} 相同。
至此,得到结论:
AB<BA \iff (AB)[k]<(BA)[k] \iff A^{\infty}[k]<B^{\infty}[k] \iff A^{\infty}<B^{\infty}
:::::
定理 7 A<B^{\infty} \iff A<BA 。
:::::success[证明]
若 A 是 B^{\infty} 的前缀:
此时 A<B^{\infty} 。
设 B^{\infty}=AC ,则 B^{\infty}=BB^{\infty}=BAC ,得 BA 是 B^{\infty} 的前缀。
因为 |A|<|BA| ,所以 A<BA 。
若 A 不是 B^{\infty} 的前缀:
设 \operatorname{LCP}(A,B^{\infty})=k ,根据定义其满足如下两个性质:
因为 \operatorname{LCP}(A,B^{\infty})=k ,所以 \operatorname{LCP}(BA,B^{\infty})=|B|+k 。
因为 |B| \ge 1 ,所以 |B|+k \ge k+1 ,所以 BA 的前 k+1 个字符一定与 B^{\infty} 相同。即 \operatorname{LCP}(A,BA)=k 。
因此 A<B^{\infty} \iff A[k]<BA[k] \iff A<BA 。
P9196 [JOI Open 2016] 销售基因链 / Selling RNA Strands
给定 n 个字符串 S_i ,字符集为 \{\tt{A},\tt{G},\tt{U},\tt{C}\} 。进行 q 次询问,给定 P,Q ,求存在多少个 S_i 满足,P 是 S_i 的前缀且 Q 是 S_i 的后缀。
:::::success[题解]
对 S_i 建 Trie 树 T_1 ,再对 S_i 的反串建 Trie 树 T_2 。对于询问,我们在 T_1 上走 P 对应的根链,在 T_2 上走 Q 对应的根链,则答案为两子树中相同元素的数目。
子树条件可以用 DFS 序刻画。我们将 S_i 在两棵树上的 DFS 序作为 i 的坐标,则询问转化为 4-side 矩形数点。差分成 2-side 后扫描线配合树状数组即可。
复杂度 O(L+(n+m) \log n) 。
:::::
:::::success[另解]
将串 S_i 变换为 S_i {\tt{\#}} S_i ,再将询问变换为 Q{\tt{\#}}P ,则 S_i 对这个询问有贡献,当且仅当 Q{\tt{\#}}P 是 S_i {\tt{\#}} S_i 的子串。
到这里就有一车做法,比如广义 SAM 上线段树合并,SA 转化为区间数颜色等。
下面介绍 ACAM 做法,我们对询问串建 ACAM,将文本串放上去匹配,在 fail 树上做若干段树链加,使用树上差分即可。
精细实现复杂度 O(L) 。
:::::
P16827 [AFOI 2025] D.谐音替换
给定 n 个字符串 S_1 \sim S_n 。称字符串 A 是优美的,当且仅当存在 i \in [1,n] ,使得 A 是 S_i 的前缀或后缀。
进行 q 次查询,给定 T ,求有多少三元组 (A,B,C) 满足 T=ABC 且 A,B,C 均是优美的。
:::::success[题解]
判定 A 和 C 是否优美是简单的,将 S_i 的所有前后缀哈希值扔到哈希表中即可 O(1) 判定。
注意到钦定 A 是前缀 / 后缀时,优美关系有单调性,可以二分求出两个数组:
设 A=T[1:i), B=T[i:j], C=T[j+1:n] 。设指示变量 P_i, Q_j 表示 A,C 的合法性,列出条件:
对第二个条件施二元容斥 [A \lor B]=A+B-[A \land B] 。分析每个条件:
复杂度 O(L \log L) 。
:::::
QOJ14808 Pen Pineapple Apple Pen
给定长为 n 的字符串 S ,求满足下列条件的八元组 (l_1,r_1,l_2,r_2,l_3,r_3,l_4,r_4) 的数目:
取模 998244353 。
:::::success[题解]
枚举 r_2,r_3 并求出 q=\text{lcs}(r_2,r_3) 。枚举 l_3 \in (r_2,r_3] 且 r_3-l_3+1 \le q ,可知 l_2 满足
l_2 <r_2-(r_3-l_3+1)+1
设 f_{i,j} 为 r_1 \le i \land l_4 \ge j 的合法 (l_1,r_1,l_4,r_4) 对数。则 (r_2,r_3,l_3) 对答案的贡献为
\sum_{l_2=1}^{r_2-r_3+l_3-1} f_{l_2-1, r_3+1}
钦定 r_1 =i \land l_4=j 计算后,对 i 维度前缀和,j 维度后缀和求得真实 f 。
枚举 l_1,l_4 并求出 p=\text{lcp}(l_1,l_4) ,列得 r_1 的约束 r_1<l_4 \land r_1-l_1+1 \le p 。解得 r_1 \in [l_1,\min(l_4-1,p+l_1-1)] ,对 f_{r_1,l_4} 更新 +1 。将 i 维度差分优化。
求出 f 后优化统计贡献过程。对 i 维度前缀和,只要查询 f_{r_2-r_3+l_3-2,r_3+1} 的值。
根据 l_3 的约束解出 r_2-r_3+l_3-2 的范围是一段区间,对 i 维度二阶前缀和即可。
前后缀 LCP / LCS 可以递推预处理。复杂度 O(n^2) 。代码。
:::::
P14363 [CSP-S 2025] 谐音替换
给定 n 个替换规则 (S_i,T_i) ,保证 |S_i|=|T_i| 。若字符串 S ,可以将某个恰为 S_i 的子串替换为 T_i 。
进行 q 次询问,给定字符串 S,T ,求 S 有多少种不同的替换能得到 T 。认为两种替换不同,当且仅当 i 不同或 S_i 的位置不同。
:::::success[解法一]
特判 S_i=T_i 和 |S| \ne |T| 的情形。
将二元组 (S,T) 分解为 (A, S_0, T_0, B) ,其中 A 是 LCP,B 是 LCS,而 S_0,T_0 是 S,T 删去 A,B 的剩余部分,容易多项式哈希实现。
规则 (S_i,T_i) 对询问的 (S,T) 产生贡献,当且仅当下列条件同时满足:
将 ((S_i)_0,(T_i)_0) 哈希后划分等价类,则只要在某类字符串中统计 A_i \in \text{suf}(A) \land B_i \in \text{pre}(B) 的 i 的数目。
对所有 A^R 建立 Trie 树,则 A_i \in \text{suf}(A) 当且仅当 A_i^R 对应点在 A 子树内,容易用 DFS 序刻画。
同理转化掉 B_i \in \text{pre}(B) 的条件。问题变为 4-side 矩形数点,差分到 2-side 后扫描线配合树状数组即可。复杂度 O(L \log L) 。
:::::
:::::success[解法二]
特判 S_i=T_i 和 |S| \ne |T| 的情形。
设变换 S \to T 为 AS_0B \to AT_0B ,添加特殊字符转化为 f(S,T)=A{\tt{\#}} S_0T_0 {\tt{\#}} B 。
规则 (S_i,T_i) 对 (S,T) 有贡献,当且仅当 f(S_i,T_i) 是 f(S,T) 的子串。
多模匹配建立 ACAM,询问时逐位读入 f(S,T) 得到若干节点,答案就是 fail 树上点集的根链并点权和。
可以参考虚树的思想进行容斥,将点集按 DFS 序排序后减去相邻 LCA 的贡献得到答案。
复杂度 O(L|\Sigma|+L\log L) 。
:::::
:::::success[解法三]
注意到 \sum (|S_i|+|T_i|) \le L ,本质不同的 \text{len} 只会有 O(\sqrt{L}) 种。
预处理每条规则的哈希值。直接枚举规则长度 k ,再枚举替换位置 i ,求出 S[i:i+k-1] 和 T[i:i+k-1] 的哈希值后查表。
复杂度 O(L\sqrt{L}) ,据说跑的飞快。
:::::
P2375 [NOI2014] 动物园
给定长为 n 的字符串 S 。对 i=1,2,\cdots,n 求出,前缀 S[:i] 中 \le i/2 的 border 数目。
多测,T \le 5 ,n \le 10^6 ,1 秒,512 MB。
:::::success[题解]
KMP 求出前缀函数 \pi[i] ,询问时暴力跳 i \gets \pi[i] 直到 2j \le i 求出答案。
取 fail 树 i \to \pi[i] ,询问变为最浅祖先 j 满足 2j \ge i ,答案为 \text{dep}_j ,树上倍增优化到 O(n \log n) ,可以通过本题。代码。
:::::
:::::success[另解]
定理 长度 \ge |S|/2 的 border 长度构成等差数列。
用最长和次长 border 求出公差,套等差数列公式即可找出 \le |S|/2 的最长 border。复杂度线性。
:::::
QOJ8701 Border
给定长为 n 的字符串 S,T ,字符集为 \tt{a} \sim \tt{z} 。对每个 i=1,2,\cdots,n 求出,令 S[i] \gets T[i] 后 S 的最长 border。询问之间独立。
:::::success[题解]
若 S[i]=T[i] 则 \text{ans}_i 为原串最长 border。否则,对原串长为 k 的 border,只要 i \in (k,n-k] 则 border 被保留。下面只考察新产生的 border。
枚举 border 长度为 k ,则 S[:k]=S[n-k+1:] 。只要求出 \text{lcp}(S,S[n-k+1:]) 即可得到差异位置 p 。可行修改位置只有 p 和 n-k+p 两个。
预处理前后缀哈希,可以 O(1) 判定单个修改是否可行,更新 \text{ans}_i 即可。
使用 Z 函数求解,总复杂度 O(n) 。代码。
:::::
CF710F String Set Queries
维护字符串集合 D ,字符集为 \tt{a} \sim \tt{z} ,支持 q 次操作:
给定 S ,将 S 插入 D 。
给定 S ,将 S 从 D 中删去。
给定 S ,查询 \sum \limits_{T \in D} \text{cnt}(T,S) ,其中 \text{cnt}(T,S) 表示 T 作为 S 的子串出现的次数。
强制在线。
:::::success[题解]
多模匹配考虑建 AC 自动机。我们对 D 维护 ACAM,加入删除的点权分别设为 1 和 -1 ,查询时用 ACAM 匹配 S ,对每个转移节点跳 fail 树的根链求点权和。对 fail 树预处理前缀和即可。
由于 fail 树是静态结构,我们考虑操作分组,每 B 个操作分一组,每组内部修改直接暴力重构,取 B=O(\sqrt{n}) 得到根号复杂度。
进一步,我们可以使用二进制分组 的技巧。维护若干大小为 1,2,4,\cdots,2^k 的 ACAM,修改操作直接新增一个大小为 1 的 ACAM。如果两个 ACAM 大小相等,则将它们暴力合并,重复这个过程直到所有 ACAM 大小不相同。
考虑每个串最多合并 \log 次,总复杂度均摊 O(n |\Sigma| \log n) 。代码。
:::::
ZR3679 组合技
给定 n 个模式串 S_i 和一个文本串 T 。字符集为 \{\tt{a},\tt{b},\tt{c},\tt{d}\} 。
求 T 的子串 T[l:r] 数目,使得任意 S_i 均在 T[l:r] 中出现。
多测,\sum n \le 10^6 ,\sum |S_i|,\sum |T| \le 2 \times 10^6 ,1 秒,512 MB。
:::::success[题解]
对 r 升序扫描线,设 S_i 在 T[:r] 中最后出现在 f_i 位置,只要 \forall i \in [1,n], f_i \ge l 。维护 \min \limits_{i=1}^n f_i 即可求值。
对 S_1 \sim S_n 建立 ACAM,拉出 fail 树,称子树内有且仅有自己一个终止点的节点为关键点,则只要考虑所有关键点。原因是 fail 树祖先—后代关系刻画了后缀关系,关键点支配所有祖先。
扫描 r 在自动机上逐位转移。设当前扫描到 u ,则 u \to \text{root} 的 fail 链上至多一个关键点 v 。我们预处理每个 u 对应的 v ,单点修改 f_v 即可。
直接用线段树维护 f 做到 O(L|\Sigma|+L\log L) 。注意到 f 值单调不降,用桶维护 f 数组,指针指向非零下标 \min\limits_{i=1}^n f_i 即可线性。
复杂度 O(L |\Sigma|) ,瓶颈在 ACAM 转移数。代码。
:::::
CF1739F Keyboard Design
题意见原题题面。4 秒,1000 MB。
:::::success[题解]
朴素暴力是,O(2^n) 枚举选哪些串,判定是否合法。做法是遍历每个选择的串,对相邻两个字符连边,则合法当且仅当建出的图去掉重边后是若干条链。
上面那个做法启发我们可以先对每个串建图,压成一条链,如果带环或者成树的字符串直接丢掉。
对压成的链建 ACAM 并在这张 DAG 上 DP。记 f_{u,S} 为当前位于 ACAM 的节点 u ,已经使用了 S 中所有字符的最大得分。转移时枚举下一个字符 c \notin S ,记走 c 这条边到达后继 v ,将 f_{u,S}+w_v 转移到 f_{v, S \cup \{c\}} 。
注意每条链可以正反走,都要塞进去。这个不会算重,因为正反走同一个串一定不优。构造方案就是记录决策点推回来。复杂度 O(|\Sigma|2^{|\Sigma|} L) 。代码有点难写。代码.
:::::
P4248 [AHOI2013] 差异
给出长为 n 的字符串 S ,记 T_i=S[i:n] ,求
\sum_{1 \le i< j \le n} (|T_i|+|T_j|-2 \times \text{lcp}(T_i,T_j))
:::::success[题解]
前面 \sum\limits_{1 \le i<j \le n} (|T_i|+|T_j|) 容易推式子变成 \frac{n(n-1)(n+1)}{2} 从而 O(1) 计算。
求出 \text{ht} 数组后,相当于我们要对区间 \min 求和。这是 AGC005B,做法是单调栈求出以 \text{ht}[x] 为 \min 的极长区间,算一下贡献。
注意单调栈一侧取等一侧不取的细节。
:::::
P6793 [SNOI2020] 字符串
给定两个长为 n 的字符串 A,B 和正整数 k 。各自取出所有长为 k 的子串组成集合 S,T 。
你需要将 S 和 T 中的元素两两匹配,匹配 s,t 的代价为 k-\text{lcp}(s,t) 。最小化代价并输出。
:::::success[题解]
不妨视匹配 s,t 的权值为 \text{lcp}(s,t) ,转为最大权完美匹配。
对 A{\tt{\#}}B 后缀排序得到 \text{ht} 数组,权值可以描述为 \text{ht} 数组的区间 \min 。由于区间 \min 满足四边形不等式,或者说相交劣于包含的性质,我们可以直接贪心匹配权值最小的边。
考虑维护贪心过程。对 \text{ht} 建小根笛卡尔树,自底向上贪心。对节点 u ,我们维护失配的 s,t 数目 x,y ,并在 u 处尽可能匹配。
形式化地,我们求出 q=\min(x,y) ,对答案累加 q \times \min(k,\text{ht}[u]) 后,将 x \gets x-q, y \gets y-q 传递给父亲进行匹配即可。
线性 SA 可以做到总复杂度线性。代码。
:::::
P6640 [BJOI2020] 封印
给定字符串 S,T ,字符集为 \{\tt{a},\tt{b}\} 。q 次询问给定 l,r ,求 S[l:r] 与 T 的最长公共子串长度。
:::::success[题解]
钦定 i 为 S 中子串的起始位置,求出最长公共子串长度,记为 f_i 。枚举最长公共子串的起点 i ,则询问 [l,r] 的答案为
\max_{i \in [l,r]} \min(f_i,r-i+1)
二分答案 k ,则 \exists i \in [l,r], \min(f_i,r-i+1) \ge k 。拆开不等式得 f_i \ge k \land r-i+1 \ge k ,转化为 \max\limits_{i \in [l,r-k+1]} f_i \ge k 。用 ST 表维护 RMQ,复杂度 1log。
视 $|S|,|T|,q$ 同阶,总复杂度 $O(n \log n)$。[代码](https://qoj.ac/submission/3002304)。
:::::
## [P17579 [JAG 2026 Summer Camp #3] Noise Cancelling](https://www.luogu.com.cn/problem/P17579)
> 称序列 $x_1 \sim x_{2m}$ 是优美的,当且仅当 $\forall i \in [1,m], x_i+x_{i+m}=0$。给定长为 $n$ 的序列 $a_i$,求优美的子数组 $a[l:r]$ 数目。
>
> $n \le 2\times 10^5$,$|a_i| \le n$,3 秒,2048 MB。
:::::success[题解]
枚举 $m=k$ 并将序列以 $k$ 为块长定长分块,则优美区间恰好跨越两个关键点。关键点数目是调和级数的 $O(n \log n)$。
考察相邻关键点 $x,y$。设优美区间的起点 $l=x-d$,我们要求 $x-d \sim x-d+k-1$ 和 $y-d \sim y-d+k-1$ 相等。这里的相等定义为 $\forall i, a_i=-b_i$。
设 $u=\text{lcp}(x,y)$ 和 $v=\text{lcs}(x-1,y-1)$。左边需要匹配 $d$ 个元素,右边需要匹配 $k-d$ 个元素,可列得约束:
- $d \le v \land k-d \le u$。
- $1 \le l \land l + 2k-1 \le n$。
- $0 \le d < k \land d <x \land x+2k-n-1$。
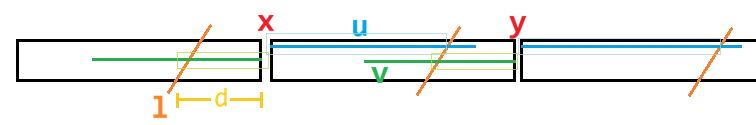
解得 $l$ 的范围是一段区间,统计贡献即可。
对于 $u$ 的求解,可以将 $a_i$ 取反拼到后面跑 SA,查询 $v$ 只要取反串 SA。
复杂度 $O(n \log n)$。[代码](https://www.luogu.com.cn/article/un28alot)。
:::::
## [ZR3583 字符串题](https://www.zhengruioi.com/problem/3583)
> 给定长为 $n$ 的字符串 $S$,字符集为 $\tt{a} \sim \tt{z}$。计数四元组 $(i,j,k,l)$ 的数目,满足:
>
> - $1 \le i \le j \le n$,$1 \le k \le l \le n$。
> - $S[i:j]$ 是 $S[k:l]$ 的后缀。
> - $(j-i+1) \mid (l-k+1)$。
>
> 对 $998244353$ 取模。
>
> $n\le 2 \times 10^5$,4 秒,1024 MB。
:::::success[题解]
记 $x=j-i+1,y=l-k+1$。不妨对原串取反,则 $S[i:j]$ 是 $S[k:l]$ 的前缀等价于 $\text{lcp}(S[i:j],S[k:l])=x$。
对 $S^R$ 后缀排序。枚举 $i,k$,在 $\text{ht}$ 上求出
$$
\begin{aligned}
f(i,k)&=\text{lcp}(S[i:], S[k:])\\
&=\min\limits_{x \in (\text{rk}[i],\text{rk}[k]]} \text{ht}[x]
\end{aligned}
$$
记 $f(i,k)=m$,再枚举 $x \in [1,m]$,则 $x \mid y \land y \le n-k+1$。故答案式为
$$
\sum_{i=1}^n \sum_{k=1}^n \sum_{x=1}^m \left\lfloor \dfrac{n-k+1}{x}\right \rfloor
$$
交换求和顺序
$$
\sum_{k=1}^n \sum_{x=1}^n \left\lfloor \dfrac{n-k+1}{x}\right \rfloor \sum_{i=1}^n [f(i,k) \ge x]
$$
根据数论分块的结论,$\left\lfloor \dfrac{n-k+1}{x}\right\rfloor$ 为定值的 $x$ 构成 $O(\sqrt{n})$ 段区间 $[l,r]$。取固定的 $k$,枚举所有区间,只要求出
$$
\sum_{x \in [l,r]} \sum_{i=1}^n [f(i,k) \ge x]
$$
将 $[l,r]$ 差分为 $[1,r] \setminus [1,l)$,则单个 $r$ 对应的答案
$$
\sum_{i=1}^n \min(r,f(i,k))
$$
建立 $\text{ht}$ 数组的小根笛卡尔树,则 $f(i,k)$ 等于 $\text{lca}(\text{rk}[i]+1, \text{rk}[k])$ 的点权。考察 $\text{rk}[k]$ 根链,我们找出最浅的祖先 $u$ 满足 $w_u \ge r$,则 $u$ 子树内贡献为 $r \times \text{sz}_u$,$u$ 子树外贡献为点权和。预处理树上前缀和即可。
使用树上倍增寻找 $u$ 的复杂度为 $O(n \sqrt{n} \log n)$,较难通过。考虑平衡复杂度,取 $B=\sqrt{n}$ 做值域分块,对每个节点 $u$ 预处理:
- $f_{u,k}$ 为点权 $\ge k \times B$ 的最浅祖先。
- $g_{u,k}$ 为点权 $\ge w_u-k$ 的最浅祖先,其中 $k \le B$。
对 $f,g$ 的预处理是根号的,查询只要跳 $O(1)$ 次祖先。这样我们做到了 $O(n\sqrt{n})-O(1)$,总复杂度严格 $O(n\sqrt{n})$。
:::::
## [CF914F Substrings in a String](https://www.luogu.com.cn/problem/CF914F)
> 给定字符串 $S$,字符集为 $\tt{a} \sim \tt{z}$,支持 $q$ 次操作:
>
> - 给定 $i,c$,令 $S[i] \gets c$。
> - 给定 $l,r,T$,求 $T$ 在 $S[l:r]$ 的出现次数。
>
> $|S|,q, \sum |T| \le 10^5$,6 秒,250 MB。
::::::success[题解]
对字符维护位置集合 $P_c=\{i \mid S[i]=c\}$。
为方便叙述,我们定义集合平移 $A-k=\{x - k\mid x \in A\}$。枚举 $x$ 为匹配的起始位置,则必有
$$
\begin{aligned}
&\forall k \in [0,|T|), S[x+k]=T[k] \\
&\iff x+k\in P_{T[k]} \\
&\iff x \in P_{T[k]}-x
\end{aligned}
$$
设所有合法的 $x$ 构成集合 $M$,则必有
$$
M=\bigcap_{k=0}^{|T|-1} (P_{T[k]}-k)
$$
对于区间匹配,只要将 $[l,r-m+1]$ 对 $M$ 取交,集合中元素的总数即为答案。注意特判 $|T|>r-l+1$。
所有集合操作都可以用 bitset 优化。视 $|S|,\sum |T|$ 同阶,时间 $O\left(\dfrac{n^2}{w}\right)$,开 $|\Sigma|$ 个 bitset 空间可以接受。[代码](https://codeforces.com/contest/914/submission/391028421)。
:::::info[Shift-And]
我们将 $\bigcap\limits_{k=0}^{|T|-1} (P_{T[k]}-k)$ 这个匹配算法称作 **Shift-And 算法**。使用 bitset 优化可以做到 $O\left(\dfrac{nm}{w}\right)$,适用于字符集不大的情形。
:::::
::::::
## [CF963D Frequency of String](https://www.luogu.com.cn/problem/CF963D)
> 给定字符串 $S$,进行 $q$ 次询问,给定 $k,M$,你需要选取 $S$ 的子串 $T$ 使得 $M$ 作为 $T$ 的子串出现至少 $k$ 次,最小化 $|T|$ 并输出,或报告无解。
>
> 字符集为 $\tt{a} \sim \tt{z}$,保证询问的 $M$ 互不相同。
>
> $|S|,q ,\sum |T| \le 10^5$,1.5 秒,500 MB。
:::::success[题解]
我们使用 Shift-And 算法求得 $M$ 在 $S$ 中出现位置的 bitset。利用 `_Find_next` 找出所有匹配位置,设其为 $a_1 \sim a_m$,则答案为
$$
\min_{i=1}^{m-k+1} (a_{i+k-1}-a_i+|M|)
$$
我们声称,暴力扫描 $a$ 序列求答案的复杂度是正确的。这是因为,对 $n$ 个互不相同的模式串 $T_i$,它们在文本串 $S$ 中出现次数之和是 $O\left( |S| \sqrt{\sum \limits_{i=1}^n |T_i|}\right)$ 的。
视 $q,|S|,\sum |T|$ 同阶,总复杂度 $O\left(n \sqrt {n}+\dfrac{n^2}{w}\right)$。[代码](https://codeforces.com/contest/963/submission/391320107)。
:::::
## [P9482 [NOI2023] 字符串](https://www.luogu.com.cn/problem/P9482)
> 给定长为 $n$ 的字符串 $S$,进行 $q$ 次询问,给定 $i,r$,保证 $i+2r<n$,求 $l$ 的数目满足:
>
> - $l \in [1,r]$。
> - $S[i:i+l-1]<(S[i+l:i+2l-1])^R$。
>
> 多测,$T \le 5$,$n,q \le 10^5$,字符集为 $\tt{a} \sim \tt{z}$,1 秒,512 MB。
:::::success[题解]
设 $l$ 的约束为 $A$,寻找某个必要条件 $B$,单步容斥 $A=B-(B \land \lnot A)$。
对于本题,将 $A$ 放缩为 $S[i:] < (S[:i+2l-1])^R$,作为条件 $B$。我们先对条件 $B$ 计数。
将 $S{\tt{\#}}S^R$ 后缀排序,认为 $\tt{\#}$ 小于所有字符。转化为
$$
\text{rk}[i]<\text{rk}[2n+3-i-2l]
$$
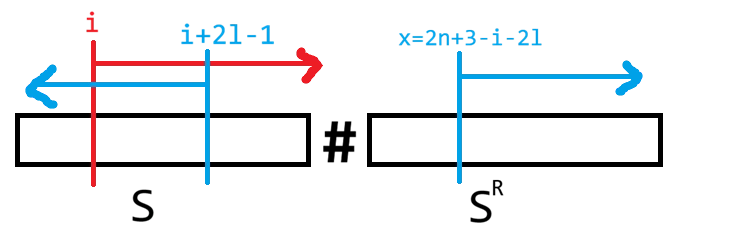
令 $x=2n+3-i-2l$ 则有:
- 由 $l \in [1,r]$ 推得 $x \in [2n+3-i-2r,2n+1-i]$。
- 由 $l \in \mathbb{Z}$ 推得 $x+1 \equiv i \pmod 2$。
- 由 $B$ 条件推得 $\text{rk}[x]>\text{rk}[i]$。
拍到 $(x,\text{rk[x]})$ 二维平面,询问是 3-side 矩形数点。对 $y$ 轴降序扫描线,树状数组分别维护 $x$ 上奇偶点即可。
再对 $C=B \land \lnot A$ 的条件计数。写出要求
$$
\left\{\begin{matrix}
S[i:] < (S[:i+2l-1])^R\\
S[i:i+l-1]\ge (S[i+l:i+2l-1])^R
\end{matrix}
\right.
$$
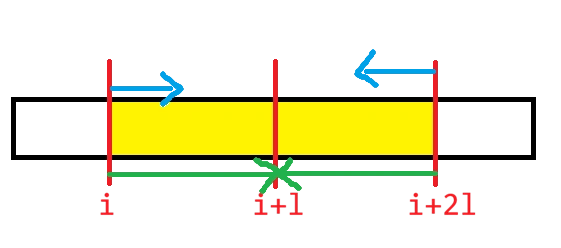
画图推导,不难发现必有 $S[i:i+l-1]=(S[i+l:i+2l-1])^R$ 成立。换言之,**$\mathbf{S[i:i+2l-1]}$ 是偶回文串。**
用 Manacher 求出 $i \to i+1$ 为中心的偶回文半径 $d_i$。令 $c=i+l-1$,则回文条件刻画为 $l \le d_c$。
向后比较字典序,$C$ 条件转化为 $S[i+2l:]<(S[:i-1])^R$,等价于 $S[c+l+1:]<(S[:c-l])^R$。转而枚举 $c$,我们要对 $l \in [1,d_c]$ 判定 $S[c+l+1:]<(S[:c-l])^R$ 是否成立。
**性质** $S[c+l+1:]<(S[:c-l])^R \iff S[c+d_c+1] < S[c-d_c]$。
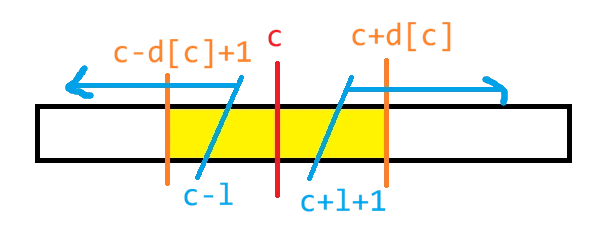
**证明** 由 $S[c-d_c+1:c+d_c]$ 回文知,对任意 $l \le d_c$,子串 $c+l+1 \sim c+d_c$ 恰为 $c-l \sim c-d_c+1$ 的翻转。从而 LCP 长为 $d_c-l$,只要比较下一位即可。
这个判定条件与 $l$ 无关。询问 $(i,r)$ 转而对 $c$ 计数,只要:
- $S[c+d_c+1] < S[c-d_c]$。
- $\exists l \in [1,r], c=i+l-1 \land l \le d_c \land i+2l-1 \le n$。
等价地,用 $c$ 表示约束:
- $c \in [i,i+r-1]$。
- $i \ge c-d_c+1$。
转 $(c,d_c)$ 二维平面分析,只保留 $S[c+d_c+1] < S[c-d_c]$ 的位置。询问是 3-side 斜矩形数点:
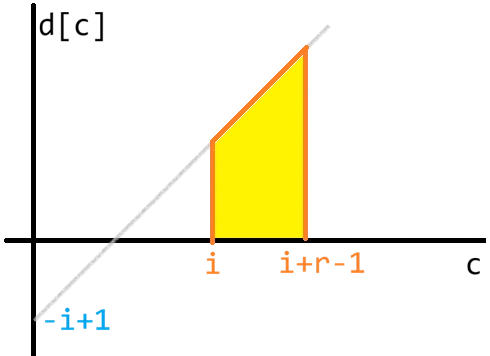
施加变换 $(x,y) \to (x,x-y)$ 将 3-side 斜矩形拉平为 3-side 矩形,扫描线配合树状数组简单解决。
视 $n,q$ 同阶单测复杂度 $O(n \log n)$。[代码](https://qoj.ac/submission/3157374)。
:::::
## [AGC064C Erase and Divide Game](https://www.luogu.com.cn/problem/AT_agc064_c)
> A 和 B 进行博弈,A 先手。初始有集合 $S=\bigcup\limits_{i=1}^n [l_i,r_i]$,保证 $[l_i,r_i]$ 两两不交。
>
> 玩家每轮可以进行如下操作之一:
>
> - 删除 $S$ 中所有奇数,并将剩余数折半。
> - 删除 $S$ 中所有偶数,并将剩余数折半下取整。
>
> 当 $S=\varnothing$ 时当前玩家失败。
>
> 两人绝顶聪明,求游戏的获胜方。
>
> 多测,$\sum n \le 10^4$,$l_i \le r_i \le 10^{18}$,2 秒,1024 MB。
:::::success[题解]
首先是一个朴素做法:将 $S=\bigcup\limits_{i=1}^n [l_i,r_i]$ 中所有数插入 01-Trie 中,01-Trie 从低位向高位建立。这样每轮的操作就是从根开始,选出一棵子树作为下一轮的根,并将另一棵子树扔掉。
对着这个在 01-Trie 上博弈 DP 即可得到答案,复杂度 $O(V \log V)$。
考虑构造一个和 01-Trie 等效的 DFA。做法是,将每个 $[l_i,r_i]$ 剖成 $O(\log V)$ 段区间,总共得到 $O(n \log V)$ 个区间,按照通配符长度降序排序后依次插入 DFA 中。直接做可能会建成 NFA,解决方案是改成函数式编程,类似于可持久化时 path-copy 的做法,将当前节点分裂。这样建出的就是一个 DFA 了。
这个 DFA 是个 DAG,在上面 dp 即可。复杂度 $O(n \log^2 V)$。
感觉其实可以作为一个套路,对于 $\bigcup\limits_{i=1}^n [l_i,r_i]$ 建立 01-Trie 后 dp 的题,我们都可以建一个 DFA 再 dp。
:::::
:::::info[代码]
```cpp line-numbers
const int N = 4e7 + 5;
int n;
using node = pair<int, i64>; // {k, val}
vector<node> vec;
void extract(i64 l, i64 r) {
while (l <= r) {
int k = l ? min(60LL, ctz(l)) : 60;
while (k >= 0 && l + (1LL << k) - 1 > r) k--;
vec.emplace_back(k, l >> k);
l += 1LL << k;
}
}
int tot, ch[2][N], p[100];
int clone(int u) {
int x = ++tot;
ch[0][x] = ch[0][u], ch[1][x] = ch[1][u];
return x;
}
void init() {
// 1 -0-> 2 -0-> ... -0-> 60
tot = 0, p[61] = ++tot, ch[0][tot] = ch[1][tot] = 0;
for (int d = 60; d >= 0; d--) {
p[d] = ++tot;
ch[0][p[d]] = p[d + 1], ch[1][p[d]] = 0;
}
}
int insert(int u, int dep, i64 val, int k) {
// (len)*****010110...
if (dep >= k && val == 0 && (u == 0 || u == p[dep])) return p[dep];
int x = clone(u);
if (dep > 60) return x;
if (dep < k) {
ch[0][x] = ch[1][x] = insert(ch[0][x], dep + 1, val, k);
} else {
if (val & 1) ch[1][x] = insert(ch[1][x], dep + 1, val >> 1, k);
else ch[0][x] = insert(ch[0][x], dep + 1, val >> 1, k);
}
return x;
}
int mem[N];
bool dfs(int x) {
if (!x) return 0;
if (mem[x] != -1) return mem[x];
return mem[x] = !dfs(ch[0][x]) || !dfs(ch[1][x]);
}
void _main() {
cin >> n; vec.clear();
for (i64 i = 1, l, r; i <= n; i++) {
cin >> l >> r;
extract(l, r);
}
sort(vec.begin(), vec.end(), greater<node>());
init(); int s = 0;
for (auto [k, val] : vec)
s = insert(s, 0, val, k);
fill(mem, mem + tot + 1, -1);
cout << (dfs(s) ? "Takahashi" : "Aoki") << '\n';
}
```
:::::
## [P3526 [POI 2011] OKR-Periodicity](https://www.luogu.com.cn/problem/P3526)
> 给出一个字符串 $S$,要求构造一个 01 串 $T$ 使得 $|S|=|T|$ 且 $\text{per}(S)=\text{per}(T)$。$\text{per}$ 表示字符串所有周期的集合。
>
> 最小化 $T$ 的字典序并输出,或报告无解。
>
> 多测,$T \le 20$,$|S| \le 2 \times 10^5$,字符集 $\tt{A} \sim \tt{Z}$,1 秒,512 MB。
::::::success[题解]
下文记 $|S|=n$。
**引理 1** $S$ 存在长为 $l$ 的 border,当且仅当 $S$ 存在 $n-l$ 的周期。
将周期性转化成 border 思考。
若 $S$ 不存在 border,我们只要构造一个不含 border 的 01 串。容易发现 $\tt{00\cdots01}$ 是最优的。
否则,取出 $S$ 的最长 border,设其长度为 $l$。我们对 border 是否覆盖原串分类讨论:
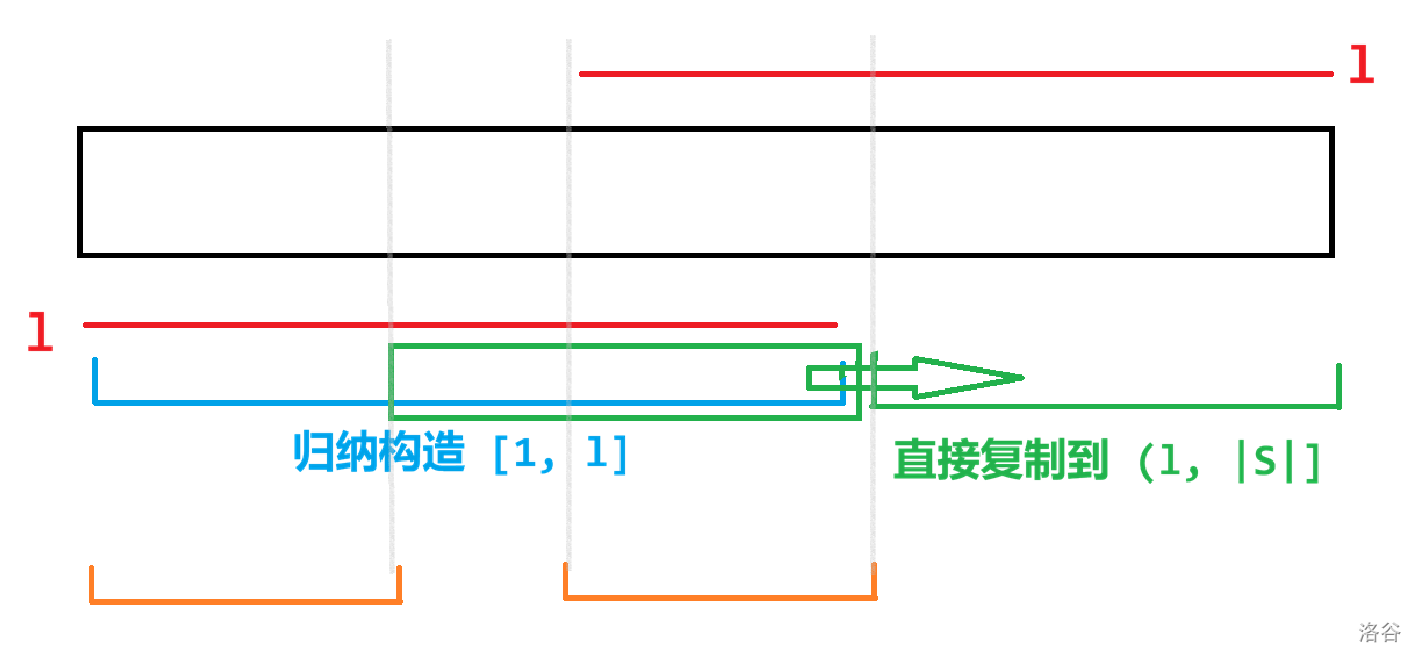
若 $2l \ge n$,两段前后缀覆盖整串。将问题规约到 $S[1:l]$ 的构造,对 $1 \sim l$ 归纳构造后,将这段字符串的后缀直接复制到 $l+1\sim n$ 即可。如图:
:::::success[证明]
最优性显然。记 $\text{bd}(S)$ 为字符串 $S$ 所有 border 长度的集合,只要证 $\text{bd}(S)=\text{bd}(T)$。
**引理 2** 设 $S$ 的最长 border 长度为 $l$,则 $\text{bd}(S[1:l])=\text{bd}(S) \setminus \{l\}$。由 KMP 的正确性得到。
**引理 3** 若字符串 $S$ 具有两个不同周期 $p,q$ 且 $|S| \ge p+q$,则 $\gcd(p,q)$ 也是 $S$ 的周期。称为**弱周期引理**。
由策略得 $T[1:l]=T[n-l+1:n]$,从而 $l \in \text{bd}(T)$。故 $T$ 具有周期 $p=n-l$。
下证 $l$ 是 $T$ 的最长 border。
::::success[证明]{open}
假设 $l' \in \text{bd}(T)$ 且 $l' >l$,则 $T$ 同时存在周期 $p=n-l$ 和 $q=n-l' <n-l$。
此时 $p+q<2n-2l$,代入 $2l \ge n$ 得 $p+q < n$。由引理 3 得 $d=\gcd(p,q)$ 是 $T$ 的周期。
进而 $d$ 也是 $T[1:l]$ 的周期。由归纳假设 $S[1:l]=T[1:l]$ 得 $d$ 是 $S[1:l]$ 的周期。且 $d \mid p$,故 $d$ 是 $S$ 的周期,因此 $n-d \in \text{bd}(S)$。
由 $d<p$ 推知 $n-d<l$,与 $l$ 是 $S$ 的最长 border 矛盾。证毕。
::::
下证 $\text{bd}(S) =\text{bd}(T)$。
::::success[证明]{open}
由引理 2 得
$$
\text{bd}(S[1:l])=\text{bd}(S) \setminus \{l\}\\
\text{bd}(T[1:l])=\text{bd}(T) \setminus \{l\}
$$
代入归纳假设 $S[1:l]=T[1:l]$ 得 $\text{bd}(S)=\text{bd}(T)$。
::::
:::::
若 $2l<n$,仍对 $1 \sim l$ 归纳构造,并将这段构造复制到 $n-l \sim n$ 的后缀上。但此时我们需要决策中间段的填法。
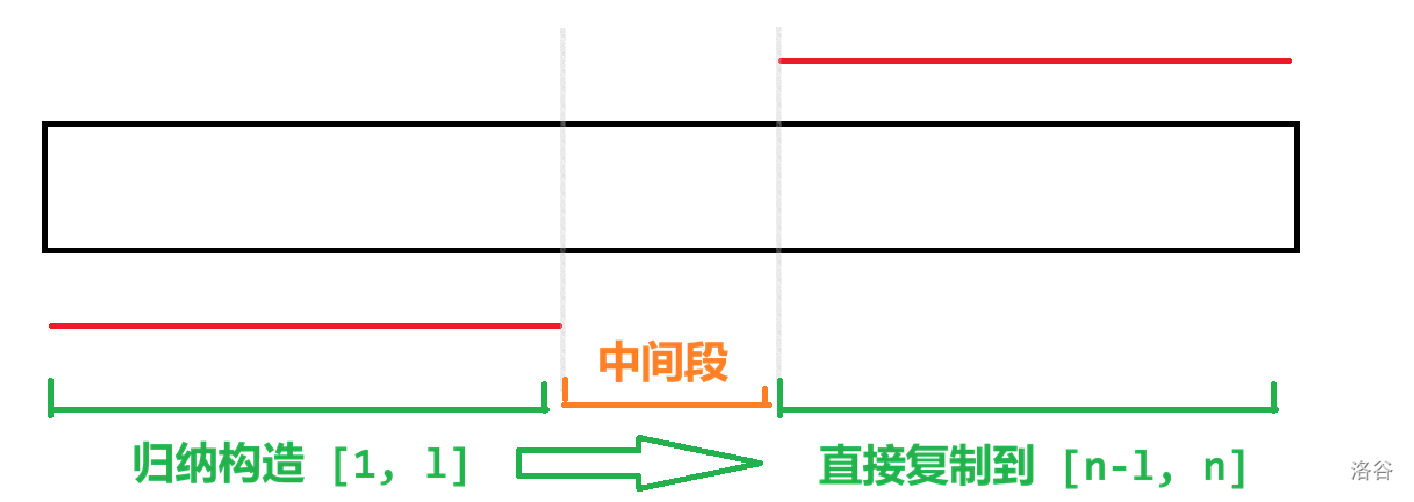
我们断言:中间段填入 $\tt{00\cdots00}$ 和 $\tt{00\cdots 01}$ 至少有一个串 $T$ 合法。最优性显然。
笔者拼尽全力无法证明这个策略的正确性,所以只能给出感性理解了。
- 若填入 $\tt{00\cdots00}$ 不合法,必然 $\exists l' \in \text{bd}(T),l'>l$。原因是 $\tt{0}$ 将前后缀连接起来了。
- 于是我们将最后一个 $\tt{0}$ 改为 $\tt{1}$ 即可切断联系。
根据上述做法递归前缀即可。
使用 KMP 求前缀最长 border,注意到 $2l<n$ 时每层规模折半,$2l \ge n$ 时直接复制,由递归式 $T(n)=T\left(\dfrac{n}{2}\right)+O(n)$ 得复杂度 $O(n)$,注意精细实现。
::::::
::::::info[代码]
```cpp line-numbers
const int N = 2e5 + 5;
int n, f[N], g[N];
char s[N], t[N];
void kmp(int n, char* s, int* pi) {
for (int i = 2; i <= n; i++) {
int j = pi[i - 1];
while (j > 0 && s[j + 1] != s[i]) j = pi[j];
if (s[j + 1] == s[i]) j++;
pi[i] = j;
}
}
void solve(int n) {
if (n == 0) return;
if (n == 1) return t[n] = '0', void();
int l = f[n];
if (l == 0) return fill(t + 1, t + n, '0'), t[n] = '1', void();
solve(l);
if (2 * l >= n) return copy(t + 2 * l - n + 1, t + l + 1, t + l + 1), void();
copy(t + 1, t + l + 1, t + n - l + 1);
fill(t + l + 1, t + n - l + 1, '0');
kmp(n, t, g);
auto chk = [&]() -> bool {
for (int i = l, j = g[n]; i > 0 && j > 0; i = f[i], j = g[j]) {
if (i != j) return false;
if (i == 0 || j == 0) return (i == 0) && (j == 0);
}
return true;
};
if (!chk()) t[n - l] = '1';
}
void _main() {
cin >> (s + 1); n = strlen(s + 1);
kmp(n, s, f), solve(n);
for (int i = 1; i <= n; i++) cout << t[i];
cout << '\n';
}
```
::::::
## [ARC175F Append Same Characters](https://www.luogu.com.cn/problem/AT_arc175_f)
> 给定 $n$ 个字符串 $S_i$。你可以进行两种操作:
>
> - 选定字符 $c \in \Sigma$,对 $\forall i$ 令 $S_i \gets S_ic$。
> - 选定 $i,j$ 并交换 $S_i,S_j$。
>
> 要求操作后序列字典序不降,最小化操作次数并输出。
>
> $n,\sum |S_i| \le 3\times 10^5$,字符集为 $\tt{a} \sim \tt{z}$,4 秒,1024 MB。
:::::success[题解]
::::info[无限循环串的比较]
**引理 1** 对于字符串 $S$,其同时拥有两个不同周期 $p,q$。若 $|S| \ge p+q$,则 $\gcd(p,q)$ 也是 $S$ 的周期。
**引理 2** 比较 $A^{\infty}$ 与 $B^{\infty}$,**等价于**比较 $AB$ 与 $BA$。
**引理 3** 若 $A^{\infty} \ne B^{\infty}$,则 $\operatorname{LCP}(A^{\infty},B^{\infty})=\operatorname{LCP}(AB,BA)$。
**引理 4** 比较 $A$ 与 $B^{\infty}$,**等价于**比较 $A$ 与 $BA$。
::::
两个操作的顺序显然没有什么关系,不妨先进行完所有操作一再进行操作二。而操作二就是冒泡排序,其操作次数等于逆序对数。因此本题表述为:
给出 $n$ 个字符串 $S_i$,你可以任选一个字符串 $X$,令 $S_i \gets S_iX$。最小化序列逆序对数与 $|X|$ 的和。
下面分析复杂度时,视 $n, \sum |S_i|$ 同阶。
直接对着逆序对数分析很难,考虑 $X$ 对每一对 $(i,j)$ 的影响。设一对字符串是 $A,B$,不妨设 $i<j,A<B,|A|<|B|$。我们讨论满足什么条件可以使得 $AX>BX$。
- 若 $|\operatorname{LCP}(A,B)|<\min(|A|,|B|)$,显然 $AX<AY$。
- 若 $|\operatorname{LCP}(A,B)|=\min(|A|,|B|)$,此时 $A$ 是 $B$ 的前缀。设 $B=AC$。则 $AX > BX \iff AX > ACX \iff X>CX$。
下面先对 $i<j$ 时 $X>CX$ 这一种情况考虑。另一种情况是对称的 $X<CX$。
根据引理 4,我们有 $X>CX \iff X>C^{\infty}$。这说明 $C^{\infty}$ 是一个阈值,我们并不需要关心 $X$ 的内容,只需要关注 $X$ 的字典序越过了哪些 $C^{\infty}$。
现在我们需要找出所有的 $C^{\infty}$,可以使用多项式哈希解决。用一个 vector 记录哈希值为 $x$ 的字符串下标集合 $H(x)$。
依次枚举 $S_i$ 并将 $S_i$ 作为 $B$,设当前枚举到了前缀长度 $k$,可以求出前缀哈希 $h_k$。在 $H(h_k)$ 中,二分找到满足 $i<j$ 的所有 $A$,求出 $C$ 后计入 $C^{\infty}$ 的出现次数。
讨论 $C^{\infty}$ 的贡献:
- 对于 $i<j$ 的所有 $A$,$X$ 跨过 $C^{\infty}$ 使得逆序对数 $+1$。
- 对于 $i>j$ 的所有 $A$,$X$ 跨过 $C^{\infty}$ 使得逆序对数 $-1$。
这个做法也说明本质不同的 $C^{\infty}$ 只有 $O(n)$ 种,每个本质不同的 $C^{\infty}$ 的贡献为上述两种情况的出现次数作差。
因此,上述两种情形可以统一成一种。在 $O(n \log n)$ 内求出原本的逆序对数后,我们只需对变化量考虑。
将所有 $C^{\infty}$ 排序并去重后,$X$ 有贡献的区间是一段前缀。这里的排序使用了引理 2,即 4.2 中的 $\prec$。
对所有 $C^{\infty}$ 扫描线。依次增大 $X$ 的字典序,每当 $X$ 越过一个 $C^{\infty}$ 时,将对应的变化量加入答案。此时我们知道了 $X \in (Y_k^{\infty},Y_{k+1}^{\infty}]$ 时,$S_i$ 的逆序对数。贪心地,我们希望 $|X|$ 最小。
现在整个问题只差最后一步:求满足 $X \in (Y_k^{\infty},Y_{k+1}^{\infty}]$ 的 $|X|_{\min}$。
记 $l=\operatorname{LCP}(Y_k^{\infty},Y_{k+1}^{\infty})$。根据引理 3,$l=\operatorname{LCP}(Y_k Y_{k+1}, Y_{k+1}Y_k)$,可以使用二分哈希 $O(\log n)$ 算出。
- 若 $|X|\le l$,为了让 $X>Y_k^{\infty}$,我们只能将前 $l$ 个字符中的一些改大,但是这样会导致 $X>Y_{k+1}^{\infty}$,不符合题意。
- 若 $|X|>l$:
- 因为 $Y_k^{\infty} < Y_{k+1}^{\infty}$,所以 $Y_k^{\infty}[l]<Y_{k+1}^{\infty}[l] \le \tt{z} \implies Y_k^{\infty}[l] \ne \tt{z}$。
- 可以将前 $l$ 个字符复制下来,并且将第 $l+1$ 位后移一位。这个构造取到了 $|X|_{\min}=l+1$。
在扫描线的最后,当 $X$ 越过所有 $Y^{\infty}_k$ 时产生一个 corner case。对于这种情况,我们先找到 $Y^{\infty}_{\max}$。
- 如果其形如 $Y^{\infty}_{\max}=\tt{zzz\cdots a \cdots }$,可以构造 $X=\tt{zzz\cdots z b}$,即求出前缀 $\tt{z}$ 的长度后加一。
- 如果其形如 $Y^{\infty}_{\max}=\tt{zzz\cdots }$,此时 $\nexists X, X>Y^{\infty}_{\max}$,故直接忽略此情况。
代码用到的唯一字符串算法是哈希,复杂度 $O(n \log^2 n)$。
理清所有思路后码量虽然大,但并不难写。[代码](https://www.luogu.com.cn/article/346grby1)。
:::::